点击右上角 微信好友
 朋友圈
请使用浏览器分享功能进行分享
天气预报模型可以看作是在地球表面铺一张方格纸,格子越密,越能看清小范围的天气情况,但随之而来的计算压力也就越大。近日,中国科学院青藏高原研究所发布“万拓”气象大模型,仅用一块80
GB显存的显卡,经过约4周训练,就将已有气象预报模型的水平分辨率从0.7°提升至0.07°,并实现每2小时更新一次,为高分辨率地球系统模型的低成本构建提供了新路径。
跨过高分辨率的算力门槛
这项研究的起点,要追溯到5年前的一次对话。
2021年,中国科学院青藏高原研究所研究员田向军与荷兰代尔夫特理工大学教授林海翔聊起再分析数据。两人判断:大气再分析数据里可能“藏”着一个比数值模式更好的AI模式,完全可以用再分析数据去训练现有AI气象大模型。
田向军介绍,计算点间距缩小到原来的十分之一,计算点数量就要增加约100倍。把天气预报做细,现有做法大致分为三条:一是靠超算硬推,把全球模式直接推到公里级,代价是需要消耗巨大的计算运行时间,难以日常化;二是数据驱动的大模型,推理只要秒级,但输出分辨率多停在0.25°、时间步长为6小时;三是把已有模型再训练一遍,把分辨率“练”出来。
“第三条路最常用但也最贵:每换一次分辨率,整套模型都得从头再训练一遍。高分辨率建模思路其实很像画素描,先勾出总体轮廓,再逐层加深细节。”田向军表示,可现有的训练框架不允许这样画,模型必须一次性建到目标分辨率,中间的成果既存不下来,也无法复用。
面对这项难题,田向军团队联合北京信息科技大学、北京大学、中国科学院大气物理研究所、国防科技大学、山东省科学院等单位开发了“万拓”气象大模型。
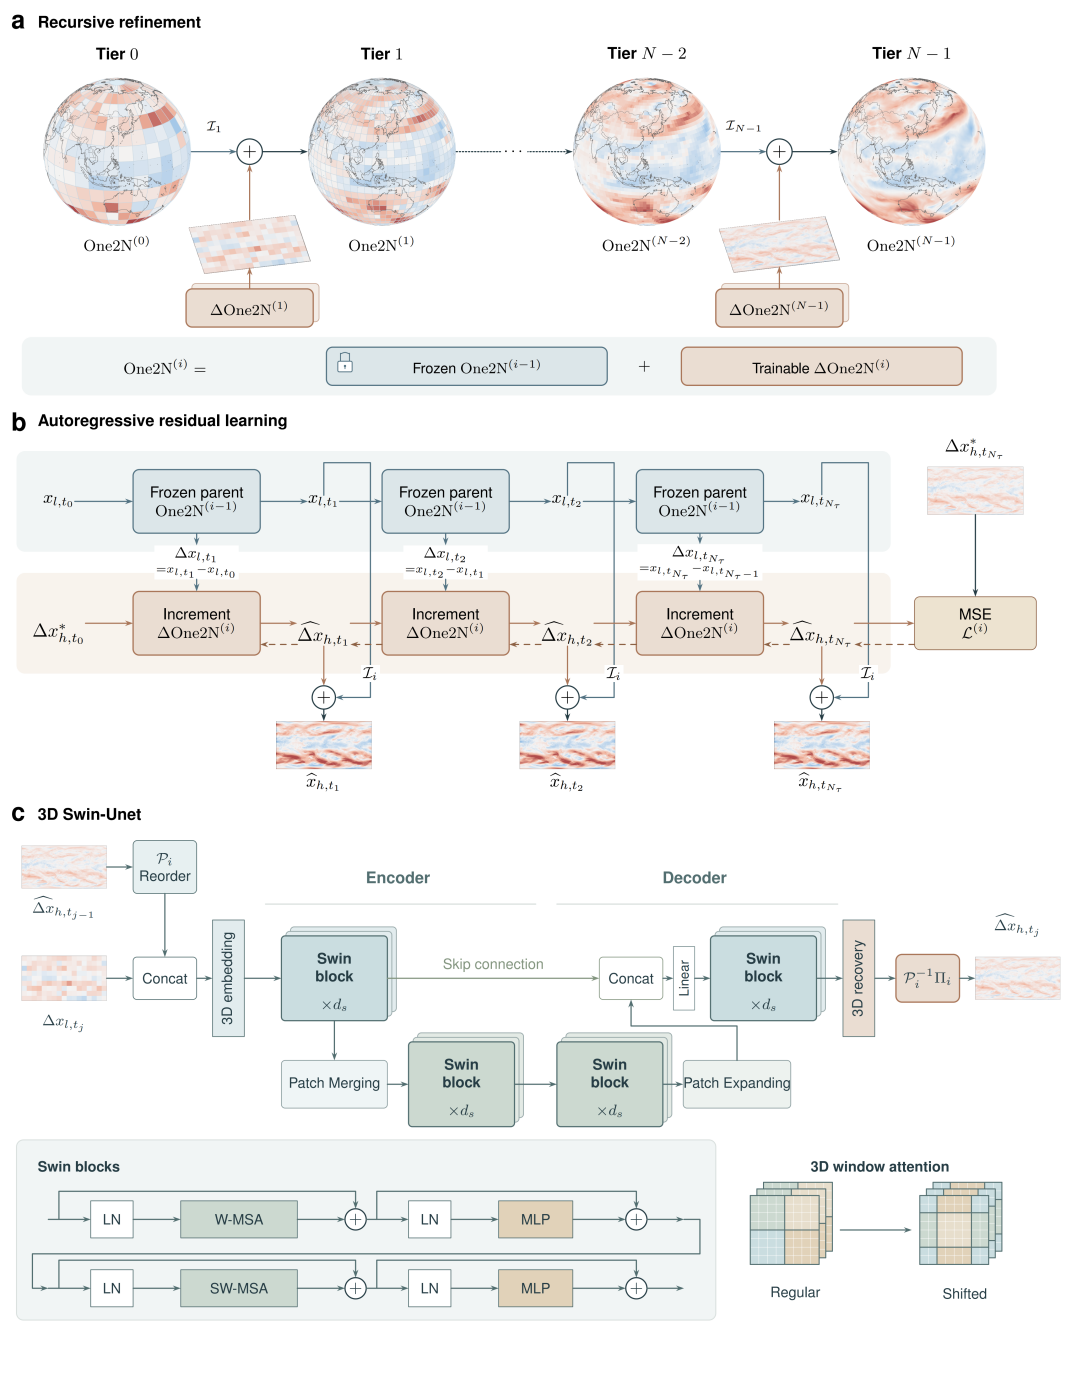
万拓(One2N)的递归细化框架,冻结父模型,只训练跨分辨率残差模块。
万拓跳出“从头训练更大的模型”的固有思路,而是采用“冻结原有模型(父模型),只学增量”的方法,不去改动模型本身,只训练新增模块,一层层叠加细节,逐步把预报变精细。
北京信息科技大学副教授王灿介绍,这一机制与渐进式增长、多网格训练,以及多模型级联等方法存在本质区别,万拓的父模型全程不动、不求导、不重训。“我们最想确认的不是能不能更准,而是在完全不动父模型的前提下,分辨率能不能真的提上去。”
打造“公里-分钟级”物理AI气象模拟器
团队用2023年120组个例做了10天全球预报评估。结果显示,万拓在提升分辨率的同时未损失预报技巧。
相较父模型,在1—7 hPa的平流层上层,位势均方根误差在12—240小时的平均相对降幅为91.10%—92.12%,1 hPa温度的相应降幅为59.14%,且从12小时一直维持到240小时。团队判断,残差模块成功校正了父模型在该层次的系统性偏差。
与0.25°数据驱动预报模型Pangu-Weather的对比显示,在1300 个检验目标中,万拓有93.46%的均方根误差更低。在台风预报方面,对2023年84个热带气旋的检验显示,相较Pangu-Weather,万拓的中位路径误差在24h-168h降低16.5%-66.9%;168小时的中位误差由1024.8公里降到339.4公里。
但如果只把万拓当成一个“把天气预报做细”的技巧,就低估了它。这套框架真正的价值是把“已有的能力”和“新增的能力”分开。
地球系统模式由大气、海洋、陆面、冰冻圈、大气化学、碳循环等分量组成,每一轮升级都要面对同一个麻烦——改一个分量,整套模式往往要重新调参、重新耦合、重新验证。沿用“冻结+增量”的思路,任何一个分量都可以在保持原有行为的前提下被细化或替换,其他分量不必推倒重来。
对地球系统模式的构建来说,这意味着模式不再是“一次建成”的整体,而是由若干可以独立演进的分量,通过状态接口拼接而成,大幅降低了系统升级的门槛与成本。
“AI预报和传统数值预报不是谁取代谁,两条路线可以一起往前走。”田向军团队长期从事数据同化的研究与应用,自主研发了国际先进的非线性最小二乘四维变分同化方法(NLS-4DVar),并构建了区域与全球的数据同化系统。他希望,下一步将万拓打造为面向青藏高原等目标区域的定制化“公里—分钟级”物理AI气象模拟器,兼顾AI的轻量化部署与物理模型的精准性,将本地观测变成本地精度,赋能千行百业。
“我们的目标不是再做一个更大的模型,而是让这套框架在高原上真正跑起来。”该研究联合第一作者、中国科学院青藏高原研究所博士生谈艳艳说。(记者 蔡琳)
习近平主持亚太经合组织第三十三次领导人非正式会议
习近平和彭丽媛为出席亚太经合组织第三十三次领导人非正式会议的来宾举行欢迎宴会